AI 長連線(SSE/WebSocket)頻繁斷流?延遲與丟包的根因排查與優化
用 ChatGPT/Claude/Gemini 時輸出到一半突然停住、過幾秒又蹦出一段、或者乾脆報 network error——這不是 AI 故障,是你的網絡環境沒針對長連線做適配。
關鍵詞:SSE 斷流、AI 長連線優化、Claude 網絡中斷、WebSocket 延遲、MTU TCP 排查
最後更新: · 內容維護:易聯 Residential IP Solution
- AI 的流式輸出是 SSE / WebSocket 長連接,一條連接要撐幾十秒到幾分鐘,中間任何一環波動都會讓輸出卡住或斷掉。
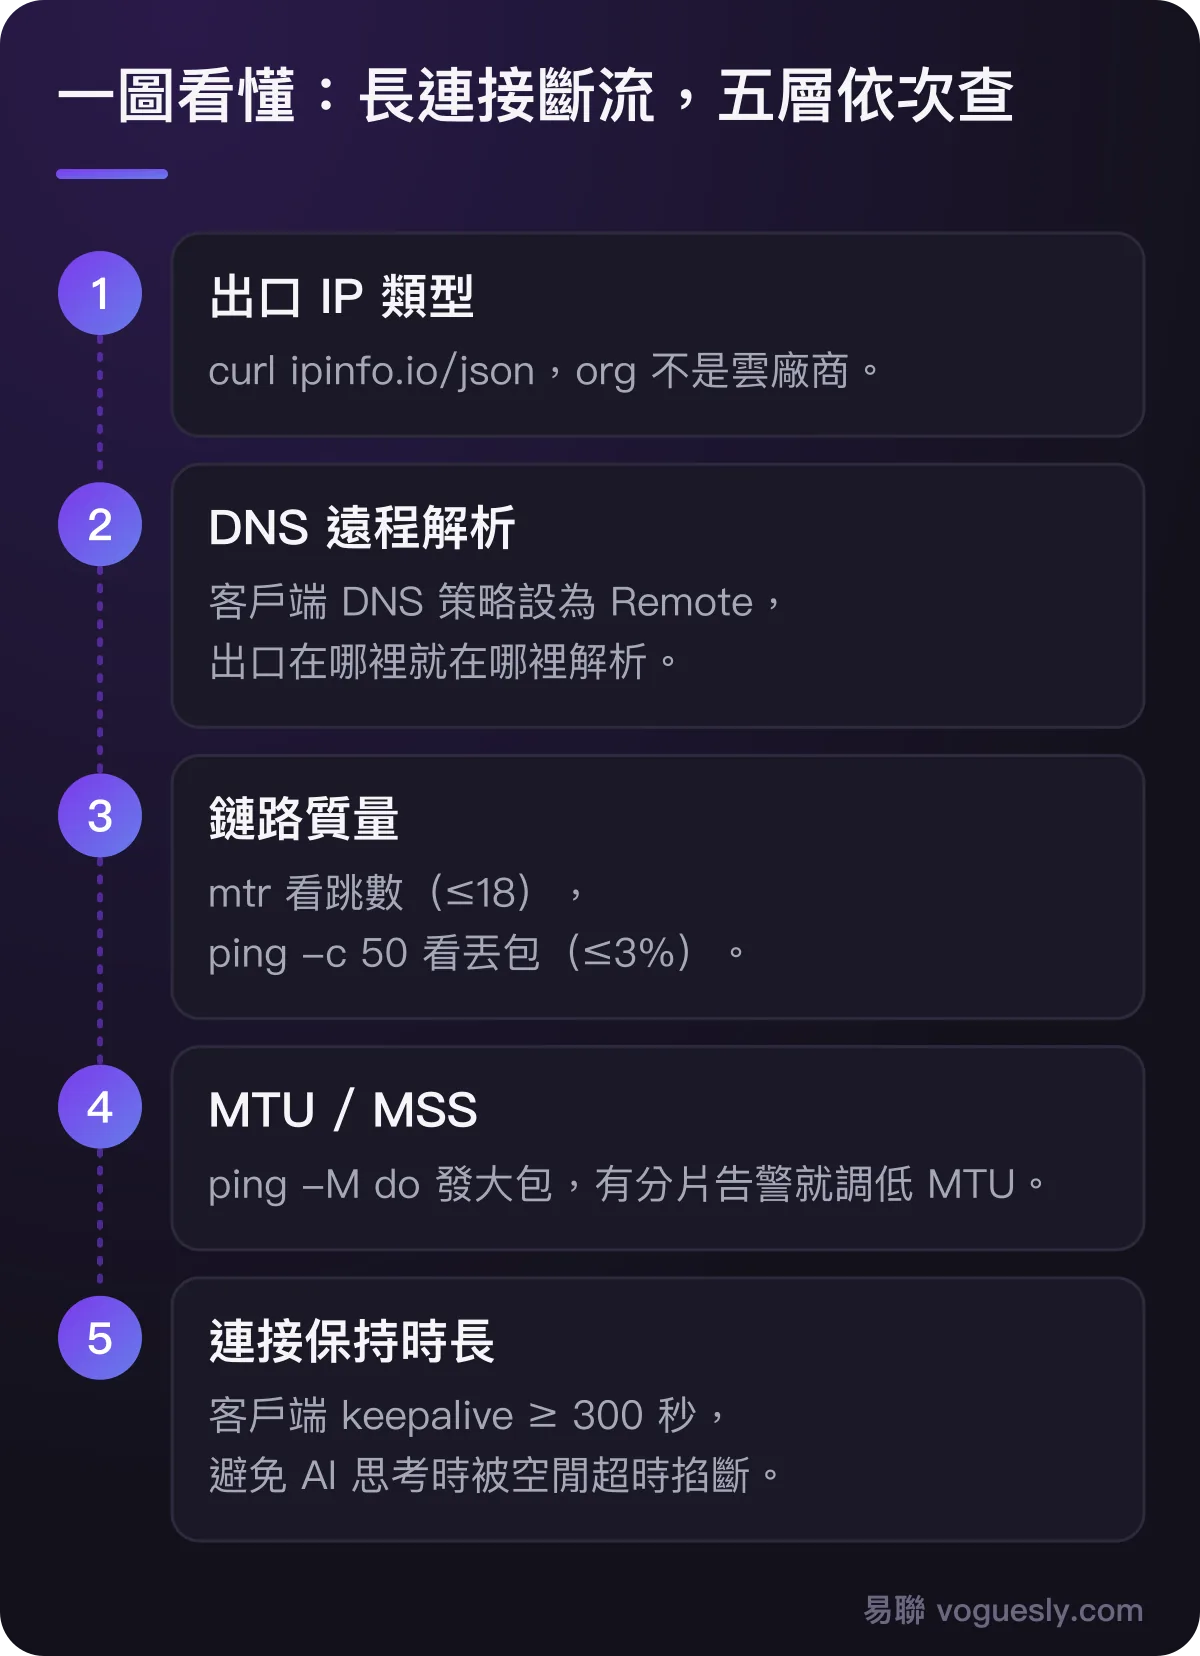
- 按五層查:出口 IP 類型、DNS 遠程解析、鏈路跳數與丟包、MTU / MSS、連接保持時長。
- 前三項修好,大部分斷流就解決了;MTU 和 keepalive 對「卡住不動」「思考久了就斷」特別關鍵。
第一層:出口 IP 類型會直接影響延遲嗎?
出口 IP 的「身份」是 AI 長連線的第一道關:
- 資料中心 IP:ASN 歸屬雲端服務商(AWS/GCP/DO/Vultr 等)。AI 服務商的風控模型對這類 IP 的「連線保持信任度」較低——即使首包通過了,後續的持續連線也可能被中間審查節點掐斷。
- 共用 IP / 輪換 IP:如果同一個 IP 同時有多個使用者在做 AI 請求(常見於公共節點的出口),AI 服務端可能因並發數異常而主動限速或中斷。
- 住宅 IP:ISP 分配的獨享 IP。ASN 不在「資料中心」名單裡,AI 服務對它的長連線信任度最高,不容易被中途掐斷。
第一層要解決的,是讓你的出口在 AI 服務的判斷裡像一個正常的、合法的個人使用者。
第二層:首包為什麼這麼慢?多半是 DNS
DNS 是對延遲影響最大、卻最容易被忽略的一層。
核心矛盾:如果你的代理客戶端的 DNS 設定是「本機解析」(Local DNS),系統會用你大陸電信業者的 DNS 去解析 api.anthropic.com / api.openai.com。
這些域名的 CDN/Anycast 會根據 DNS 來源返回離中國大陸最近的節點——但這個節點往往不在你代理出口的同一地區。結果:出口 IP 在美國,但 DNS 把域名解析到新加坡或日本的 IP——延遲憑空多了幾十毫秒,且地區不一致是附加風控訊號。
解法:把代理客戶端的 DNS 策略從「本機解析」改為「遠端解析」(Remote DNS / DNS over Proxy)。出口在哪裡,DNS 就在哪裡解析——做到 IP 和 DNS 在同一地區。
驗證方法:
- 在代理下執行
curl -v https://api.anthropic.com/v1/messages 2>&1 | grep "TLS"看握手時間。 - 對比關代理直連和開代理的 TLS 握手耗時——開代理後應該 ≤800ms(美國西海岸正常延遲)。
第三層:連線能建立卻撐不住,是鏈路品質的問題嗎?
跨境鏈路的品質,用三個指標衡量:
- 跳數(Hops):用
mtr -r api.anthropic.com數中間經過多少跳。一般期望在 10-15 跳。超過 18 跳說明路由很差。 - 丟包率(Packet Loss):用
ping -c 50 api.anthropic.com測。丟包 >5% 意味著每 20 秒左右就可能有一個包丟失,對應 AI 串流輸出的大約每 20 秒一次「卡住」。 - 抖動(Jitter):延遲的變化幅度。用
mtr -r看每跳的 Avg 和 Max 差值。Max - Avg > 40ms 說明這跳不穩定。
鏈路選擇:優先選跳數少、丟包低、晚高峰也穩定的線路。不同電信商的最佳路徑不一樣,以你本地用 mtr / ping 實測的結果為準。
第四層:為什麼大包會莫名其妙丟失?MTU 與 TCP MSS
MTU(Maximum Transmission Unit,最大傳輸單元)決定了每個 IP 包的上限。如果你的網絡環境和 AI 服務端之間的 MTU 不匹配,大的 TCP 包會被中間路由器靜默丟棄——不報錯、不通知、就像什麼都沒發生。TCP 會嘗試重傳,但同樣大小的包還是被丟,結果就是連線卡住不動。
為什麼加密隧道會讓情況更糟:
- 隧道加密頭(VLESS/XTLS ~40 位元組、WireGuard ~60 位元組)佔用 MTU 的空間
- 你的本機 MTU 可能是 1500,但隧道路徑上的鏈路 MTU 可能只有 1460 或更低
- TCP 三次握手時協商的 MSS(最大段大小)不包含隧道頭,協商出來的是錯的
- 結果:發出去的包 > 真實 MTU → 被扔 → 連線卡住
排查方法:
- 用
ping -M do -s 1472 -c 3 api.anthropic.com發大包測試,如果有分片告警,MTU 有問題。 - 從 1400 開始逐漸加大,找到剛好能過不需要分片的最大值。
- 在代理客戶端或網絡方案配置裡設這個值。
建議值:用 WireGuard 的設 MTU=1380;用 VLESS/Vision 的設全域 MTU 1300-1400;用 Clash/Stash 的檢查 tun.mtu 設定。
第五層:AI 思考幾十秒時,連線為什麼會被掐斷?
AI 從收到你的問題到開始輸出 token 的「思考」階段,可能持續 5-30 秒(複雜的推理任務甚至更長)。這段時間長連線是開啟的但沒有資料在傳輸。
如果中間有 NAT 設備或防火牆,它的「閒置連線逾時」預設可能在 60-120 秒——超過這個時間沒資料就自動切斷。對於網頁瀏覽來說這個時間完全夠(一個請求 < 2 秒),但對 AI 的長時間思考就不夠。
解法:
- 確認代理客戶端的連線保持時長 ≥ 300 秒(5 分鐘)
- 如果你用的是 UDP 承載的隧道(WireGuard / Hysteria),確認 UDP 會話的逾時足夠長
- macOS 使用者確認
sysctl net.inet.tcp.keepidle沒被改小(預設 7200000=2小時沒問題)
五層檢查清單(照著做)
遇到 AI 長連線斷流/卡住,按這個順序排查,每一步都有明確的驗證方法:
- ☐ IP 類型:curl ipinfo.io/json → org 不是雲端服務商 → 住宅 IP ✅
- ☐ DNS 遠端解析:代理客戶端 DNS 策略 = Remote → 同一地區 ✅
- ☐ TLS 基準:curl -v API → TLS 握手 ≤800ms → 正常 ✅
- ☐ 鏈路跳數:mtr API → 跳數 ≤18 跳 → 正常 ✅
- ☐ 丟包率:ping -c 50 API → 丟包 ≤3% → 正常 ✅
- ☐ MTU:ping -M do 大包檢查 → 無分片告警 → 正常 ✅
- ☐ Keepalive:代理客戶端連線保持 ≥ 300s → 正常 ✅
前 3 項是前提,修好前 3 項 80% 的斷流都解決。後 4 項屬於深度優化,每多修一項,穩定性再提一檔。